Kubernetes NetworkPolicy begrenzt Netzwerkverkehr auf IP- und Port-Ebene zwischen Pods, Namespaces und externen Netzen. Dieser Leitfaden führt dich von der CNI-Prüfung über ein namensraumweises Default Deny bis zu gezielten Freigaben für DNS und Anwendungen. So entsteht eine überprüfbare, schrittweise Isolation statt einer riskanten globalen Sperre.
Stand: 06.11.2026
Auf einen Blick
- Eine Kubernetes NetworkPolicy wirkt nur mit einem CNI, das ihre Durchsetzung unterstützt.
- Policies sind additiv: Alle passenden Erlaubnisse bilden zusammen die erlaubte Verkehrsmenge.
- Ingress und Egress sind getrennte Richtungen; für eine Pod-zu-Pod-Verbindung müssen beide Seiten passen.
- Ein Default Deny für Egress sperrt auch DNS, bis du es ausdrücklich erlaubst.
- Starte pro Anwendungs-Namespace, prüfe den Verkehr und weite den Schutz erst danach aus.
Teil 1 – Grundlagen und Planung
1. Die Ausgangslage und das Ziel
Ohne passende Policy sind Pods im Namespace standardmäßig für eingehenden und ausgehenden Verkehr nicht isoliert. Eine Kubernetes NetworkPolicy macht daraus ein Allowlist-Modell: Sie wählt Ziel-Pods per Label aus und beschreibt, welche Gegenstellen und Ports erreichbar bleiben. Deshalb ist sie ein sinnvoller Baustein neben Kubernetes-Monitoring mit Grafana und Prometheus, aber kein Ersatz für Pod-Sicherheit, TLS oder Zugriffsrechte.
Das konkrete Ziel lautet: Ein Anwendungs-Namespace erhält zuerst eine vollständige Isolation. Danach erlaubst du nur die Verbindungen, die die Anwendung tatsächlich benötigt: DNS-Auflösung, den vorgesehenen Datenbank-Port und die vorgesehenen Clients. Kubernetes beschreibt NetworkPolicy als Layer-3/4-Mechanismus für TCP, UDP und optional SCTP. HTTP-Pfade, TLS-Eigenschaften und Services nach Namen gehören nicht zum Standardmodell.
Was eine Policy auswählt
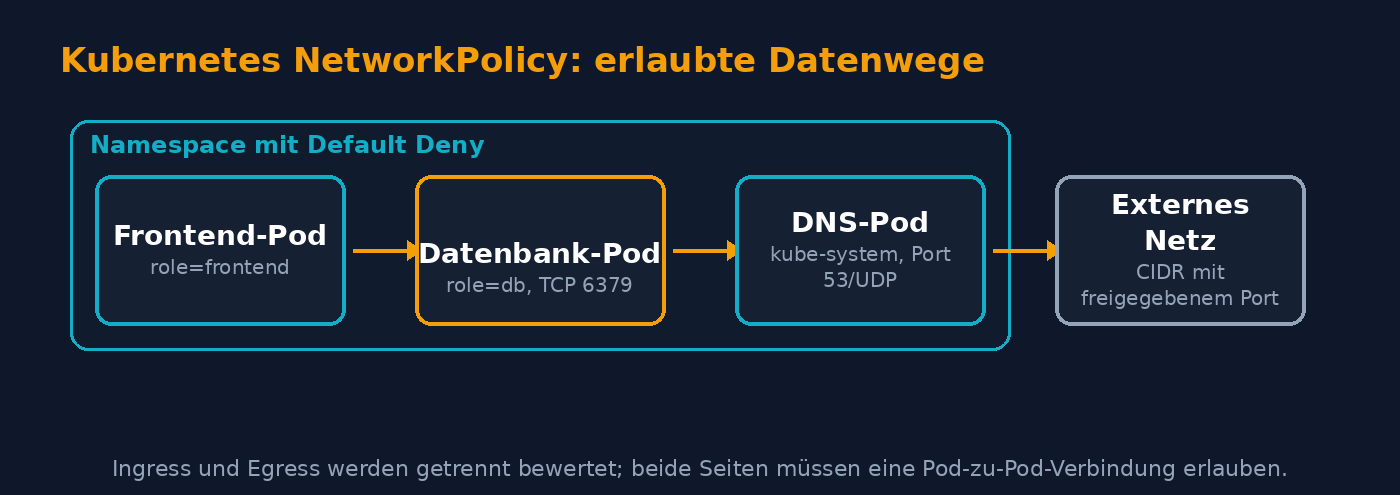
podSelector bestimmt, für welche Pods die Regel gilt. Ein leerer Selector {} wählt alle Pods des Namespace. In ingress.from und egress.to beschreibst du erlaubte Quellen oder Ziele mit Pod- und Namespace-Selektoren sowie optionalen CIDR-Blöcken. Die Policy selbst ist immer namespaced; sie kann daher nicht als Kubernetes-Standardressource pauschal alle Namespaces erfassen.
Wichtig ist die Blickrichtung: Die Ingress-Regel sitzt am Ziel-Pod, die Egress-Regel am Quell-Pod. Für eine erlaubte Verbindung von A zu B muss nach der Kubernetes-Dokumentation der Egress von A und der Ingress von B sie zulassen. Antworten auf eine erlaubte Verbindung bleiben implizit erlaubt.
2. Voraussetzungen und Architektur
Prüfe zuerst, welcher Netzwerk-Plugin-Stack im Cluster arbeitet und ob er Kubernetes NetworkPolicy durchsetzt. Das Erzeugen eines NetworkPolicy-Objekts ohne durchsetzenden Controller hat laut Kubernetes keine Wirkung. Das ist der wichtigste Vorabtest; YAML allein beweist keine Abschottung. Wenn du den Cluster erst aufbaust, lies ergänzend die Anleitung Kubernetes und Minikube verstehen sowie den Beitrag zur Migration von Docker Compose zu Kubernetes.
Die folgenden Regeln verwenden ausschließlich die Standardressource networking.k8s.io/v1/NetworkPolicy. Cilium und Calico können darüber hinaus eigene CRDs anbieten. Für einen portablen Einstieg bleibt die Kubernetes NetworkPolicy jedoch die richtige Basis. Notiere vorab Namespace, Pod-Labels, benötigte Ports, DNS-Server und externe Ziele. Labels sind kein kosmetisches Detail: Sie sind der Vertrag zwischen Deployment und Netzregel.
| Variante | Sinnvoll, wenn | Grenze |
|---|---|---|
| Standard-NetworkPolicy | Du Pods, Namespaces, CIDRs und L4-Ports erlauben willst. | Kein L7-HTTP, kein TLS und kein Service-Name als Ziel. |
| CiliumNetworkPolicy | Cilium läuft und zusätzliche Identitäts- oder L7-Regeln nötig sind. | Nicht portabel zu anderen CNIs. |
| Calico GlobalNetworkPolicy | Du mit Calico zentral steuerst und System-Namespaces bewusst ausnimmst. | Zu breite globale Regeln können Cluster-Komponenten stören. |
Namespace-Labels als stabile Grenze
Ein Namespace kann über Labels ausgewählt werden. Kubernetes setzt außerdem das unveränderliche Label kubernetes.io/metadata.name mit dem Namespace-Namen. Das ist robuster als eine vermeintliche Namensreferenz im Policy-Feld, denn NetworkPolicy bietet kein eigenes Feld dafür. Für Gruppen von Umgebungen kannst du zusätzlich ein fachliches Label verwenden.
Dieses Beispiel aus der Kubernetes-Dokumentation kennzeichnet zwei Ziel-Namespaces.
kubectl label namespace frontend namespace=frontend
kubectl label namespace backend namespace=backend
Erfolgreich ist der Schritt, wenn die Labels in der Namespace-Beschreibung erscheinen und der Selector sie später findet.
Teil 2 – Isolation zuerst, Freigaben danach
3. Kubernetes NetworkPolicy als Default Deny einführen
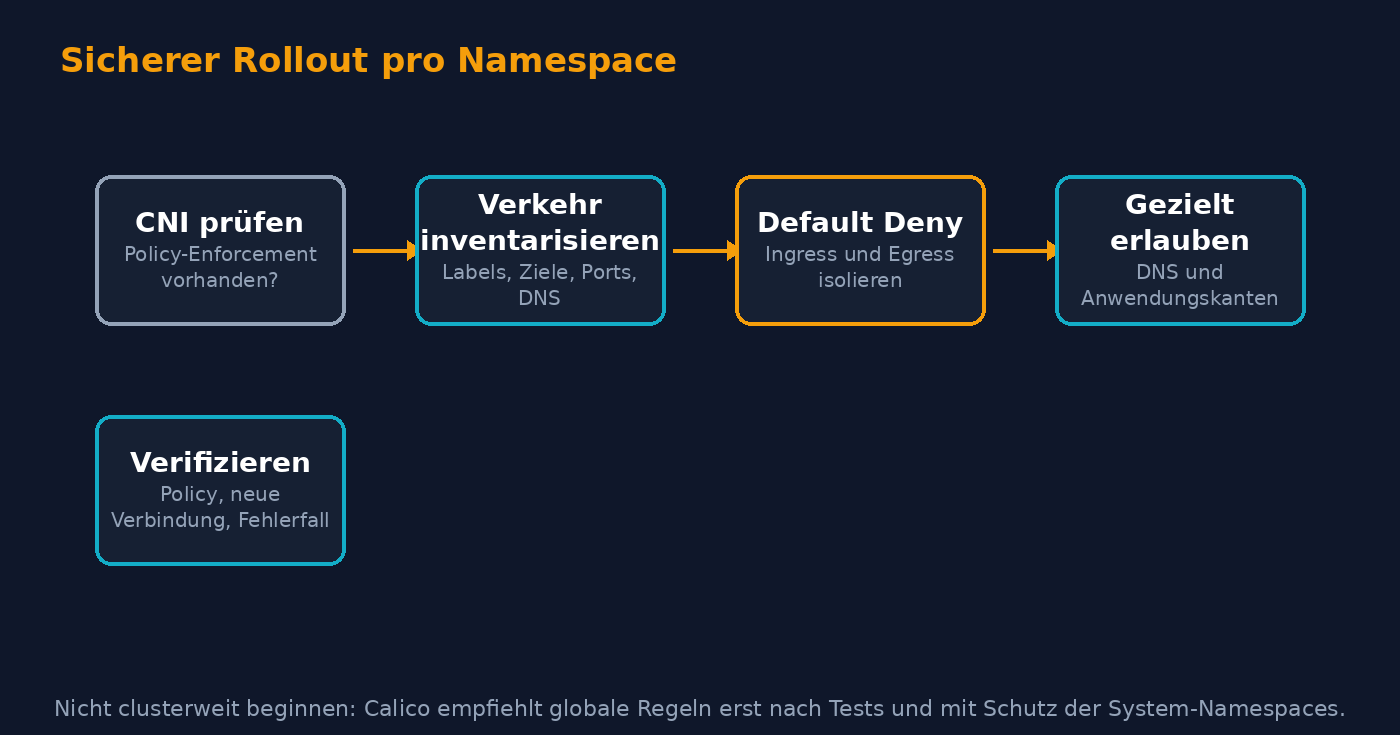
Beginne nicht clusterweit. Lege die Regel zunächst in einem einzelnen Anwendungs-Namespace an, etwa engineering. Ein leerer Pod-Selector erfasst dort alle Pods. Die beiden policyTypes isolieren beide Richtungen, während die leeren Listen bewusst keine Ausnahme enthalten. Damit wird aus dem offenen Standardverhalten eine kontrollierte Ausgangslage.
Diese Default-Deny-Regel entspricht dem Beispiel der Kubernetes- und Calico-Dokumentation; ersetze engineering nur durch deinen vorhandenen Anwendungs-Namespace.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny-all
  namespace: engineering
spec:
  podSelector: {}
  policyTypes:
  - Ingress
  - Egress
Nach dem Anwenden ist der Namespace für Ingress und Egress isoliert. Das bedeutet nicht, dass alle Pods kaputt sind, sondern dass jede benötigte Verbindung jetzt als explizite Regel dokumentiert werden muss.
Ingress und Egress getrennt testen
Für eine sanftere Einführung kannst du die Richtungen nacheinander isolieren. Eine reine Ingress-Sperre schützt vor unerwünschten Zugängen, lässt aber ausgehenden Verkehr unverändert. Das ist sinnvoll, wenn du zunächst nur den Weg zu Datenbanken oder internen Diensten eingrenzen willst.
Diese Policy selektiert alle Pods im Namespace und sperrt ausschließlich neuen Ingress.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny-ingress
spec:
  podSelector: {}
  policyTypes:
  - Ingress
Der Erfolg besteht darin, dass nur Ingress isoliert ist; Egress bleibt von dieser einzelnen Regel unberührt. Umgekehrt sperrt die folgende Variante ausschließlich neue ausgehende Verbindungen.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny-egress
spec:
  podSelector: {}
  policyTypes:
  - Egress
Erwartet wird hier eine Egress-Isolation. Deshalb folgt direkt die wichtigste Ausnahme: DNS.
4. DNS und gezielte Datenbank-Zugriffe erlauben
Eine Default-Deny-Egress-Policy blockiert laut Kubernetes auch DNS. Ohne Namensauflösung scheitern viele Anwendungen bereits vor ihrem eigentlichen Verbindungsaufbau. Erlaube DNS nicht per ungenauem CIDR, wenn dein CNI Labels am DNS-Pod auswerten kann. Das folgende Cilium-Beispiel erlaubt allen Cilium-verwalteten Endpoints UDP-Port 53 zu kube-dns im Namespace kube-system.
apiVersion: "cilium.io/v2"
kind: CiliumClusterwideNetworkPolicy
metadata:
  name: wildcard-from-endpoints
spec:
  endpointSelector:
    matchLabels:
      k8s:io.kubernetes.pod.namespace: kube-system
      k8s-app: kube-dns
  ingress:
  - fromEndpoints:
    - {}
    toPorts:
    - ports:
      - port: "53"
        protocol: UDP
Der Erfolg ist eine funktionierende DNS-Kommunikation zu den ausgewählten DNS-Pods. Dieses Cilium-Beispiel ist eine Anbieter-Erweiterung; übernimm es daher nur in einem Cilium-Cluster. Bei Calico weist die Dokumentation ebenfalls darauf hin, dass eine zentrale DNS-Freigabe einzelne DNS-Regeln pro Pod vermeiden kann.
Danach erlaubst du genau die Anwendungskante. Das offizielle Kubernetes-Beispiel wählt Datenbank-Pods mit role=db, erlaubt TCP 6379 vom Frontend und begrenzt den Egress auf einen CIDR und TCP 5978. Es zeigt zugleich: Eine Regel ist kein „Deny über Priorität“, denn mehrere passende Regeln werden vereinigt.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: test-network-policy
  namespace: default
spec:
  podSelector:
    matchLabels:
      role: db
  policyTypes:
  - Ingress
  - Egress
  ingress:
  - from:
    - podSelector:
        matchLabels:
          role: frontend
    ports:
    - protocol: TCP
      port: 6379
  egress:
  - to:
    - ipBlock:
        cidr: 10.0.0.0/24
    ports:
    - protocol: TCP
      port: 5978
Der erwartete Effekt: Frontend-Pods im selben Namespace erreichen die Datenbank auf TCP 6379; die ausgewählten Datenbank-Pods dürfen ausgehend TCP 5978 im angegebenen Netz ansprechen. Passe Labels, Ports und CIDR nur anhand deiner dokumentierten Verkehrsbeziehungen an.
Grenzen über Namespace-Labels formulieren
Wenn eine Anwendung mehrere freigegebene Namespaces erreichen muss, kombiniere einen Namespace-Selector mit einer klaren Label-Taxonomie. Ein einzelnes from-Element mit Namespace- und Pod-Selector bedeutet dabei „Pods mit diesem Label in diesen Namespaces“. Zwei getrennte Elemente wären deutlich weiter gefasst und bedeuten eine Oder-Beziehung.
Diese Regel aus der Kubernetes-Dokumentation lässt Egress von app=myapp nur zu Namespaces mit den angegebenen Labels zu.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: egress-namespaces
spec:
  podSelector:
    matchLabels:
      app: myapp
  policyTypes:
  - Egress
  egress:
  - to:
    - namespaceSelector:
        matchExpressions:
        - key: namespace
          operator: In
          values: ["frontend", "backend"]
Die Policy ist korrekt, wenn nur Pods mit app=myapp betroffen sind und Ziele ausschließlich in den gelabelten Namespaces liegen. Ergänze bei Bedarf zusätzlich einen Pod-Selector und Ports, statt den Namespace pauschal zu öffnen.
Teil 3 – Prüfen, beobachten, erweitern
5. Verifikation: So prüfst du, dass alles läuft
Prüfe zuerst, wie Kubernetes die Ressourcen interpretiert. Die offizielle Dokumentation empfiehlt bei Selector-Zweifeln ausdrücklich kubectl describe. Diese Prüfung bestätigt jedoch nur das API-Objekt, nicht die Durchsetzung durch das CNI. Kombiniere sie daher mit einem fachlichen Verbindungstest deiner Anwendung und einem Blick auf die CNI-Beobachtung, soweit dein Plugin diese bereitstellt.
Dieser Befehl zeigt die auf den Namespace bezogene Policy samt Selector, Richtungen und erlaubten Peers.
kubectl describe networkpolicy default-deny-all -n engineeringErwartet ist die Ressource default-deny-all mit leerem Pod-Selector sowie den Policy Types Ingress und Egress. Fehlt sie oder zeigt sie einen anderen Namespace, schützt sie die Ziel-Pods nicht.
Danach dokumentierst du für jede erlaubte Kante einen Solltest: DNS-Auflösung soll funktionieren, der definierte Datenbank-Port soll vom Frontend erreichbar sein und ein nicht freigegebener Port soll scheitern. Beachte dabei die Implementierungsgrenze: Beim Anlegen einer Policy kann es dauern, bis das verteilte Netzwerk-Plugin sie verarbeitet hat. Neue Pods werden nach der Verarbeitung vor ihrem Start isoliert; unmittelbar bei Änderungen kann die Sicht kurz uneinheitlich sein.
Die wichtigsten Stolperfallen
Policy existiert, Verkehr bleibt offen
Symptom: Das YAML ist im API-Server sichtbar, aber Verbindungen werden nicht eingeschränkt. Ursache: Der Netzwerk-Plugin unterstützt oder erzwingt NetworkPolicy nicht. Lösung: Prüfe vor dem Rollout die CNI-Fähigkeit; Kubernetes sagt klar, dass das Objekt ohne durchsetzenden Controller keine Wirkung hat.
Nach Default Deny funktionieren Namen nicht mehr
Symptom: Anwendungen können Hosts oder Services nicht mehr auflösen. Ursache: Egress Default Deny blockiert DNS. Lösung: Ergänze eine eng gefasste DNS-Freigabe für den tatsächlichen DNS-Service und prüfe sie vor weiteren Regeln.
Namespace- und Pod-Selector werden versehentlich getrennt
Symptom: Mehr Pods als geplant erhalten Zugriff. Ursache: Zwei Listenelemente bedeuten eine Oder-Beziehung; Namespace- und Pod-Selector standen nicht im selben Element. Lösung: Beide Selectors gemeinsam unter einem from– oder to-Eintrag schreiben und mit kubectl describe kontrollieren.
Ein ipBlock trifft Pods nicht wie erwartet
Symptom: Eine CIDR-Regel verhält sich je nach Service oder Load Balancer anders. Ursache: Quell- oder Ziel-IP kann vor oder nach der Policy-Verarbeitung umgeschrieben werden; das ist laut Kubernetes implementationsabhängig. Lösung: CIDRs für cluster-externe Ziele nutzen und interne Pod-Beziehungen mit Labels modellieren.
Globale Sperre beeinträchtigt Systemdienste
Symptom: Nach einer globalen Calico-Policy verhalten sich Cluster-Komponenten unerwartet. Ursache: Eine globale Regel kann auch Control-Plane- und CNI-Namespaces erfassen. Lösung: Erst im Staging beobachten, erlaubte Kanten ergänzen und System-Namespaces ausdrücklich aus dem Geltungsbereich nehmen.
Eine bestehende Verbindung bleibt offen
Symptom: Nach einer Policy-Änderung verhält sich eine bestehende Session anders als ein neuer Test. Ursache: Die Auswirkung auf bestehende Verbindungen ist vom Netzwerk-Plugin abhängig. Lösung: Nicht während kritischer Verbindungen umbauen und neue Verbindungen separat testen.
6. Ausbau ohne Überraschungen
Arbeite Namespace für Namespace und führe ein kleines Verkehrs-Inventar: Quelle, Ziel, Port, Protokoll, Besitzer und Test. So wird jede Kubernetes NetworkPolicy nachvollziehbar. Eine breite „allow all“-Policy kann zwar kurzfristig Fehler verdecken, hebt aber die gewünschte Isolation für diese Richtung wieder auf.
Für einen bewusst offenen Ingress gibt es in der Kubernetes-Dokumentation folgende Form. Sie eignet sich als Diagnose-Hilfsmittel, nicht als Ersatz für eine Freigabeliste.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-all-ingress
spec:
  podSelector: {}
  ingress:
  - {}
  policyTypes:
  - Ingress
Diese Policy erlaubt allen eingehenden Verkehr zu allen Pods des Namespace; weitere Ingress-Policies können ihn dort nicht mehr einschränken. Deshalb entferne oder vermeide sie, sobald die gezielten Regeln stehen.
7. Betrieb: Policies wie Anwendungscode behandeln
Lege jede Kubernetes NetworkPolicy zusammen mit Deployment und Service im selben Repository ab. Dadurch wird sichtbar, welche Labels eine Freigabe voraussetzt und welche Änderung an einer Anwendung eine Netzregel nach sich zieht. Besonders beim Umbenennen eines Labels gilt: Ein Selector, der keinen Pod mehr trifft, isoliert nichts; ein zu allgemeiner Selector kann dagegen mehr Pods erfassen als vorgesehen.
Halte die Reihenfolge im Rollout klein. Zuerst überprüfst du Labels und Namespace-Grenzen, danach legst du die Allow-Regeln an und erst dann die Default-Deny-Regel. Das ist kein Sicherheitsverlust auf Dauer, sondern eine kontrollierte Einführung: Du kennst die benötigten Verbindungen, bevor die Sperre wirkt. Für produktive Änderungen gehört außerdem ein Rückweg dazu. Eine einzelne, klar benannte Policy lässt sich leichter prüfen und zurücknehmen als eine unübersichtliche Sammelregel.
Dokumentiere auch die Grenzen des Modells. Kubernetes garantiert keine ausdrücklichen Deny-Regeln, keine Protokollierung akzeptierter oder abgelehnter Netzwerkereignisse und keine Filterung von TLS im Standard-API. Deshalb ergänzt du NetworkPolicy mit CNI-spezifischer Beobachtung, einem Ingress- oder Service-Mesh-Konzept für L7-Anforderungen und dem passenden Monitoring. Der Artikel Docker-Container sicher betreiben hilft dabei, Netzwerkregeln nicht isoliert von Image-, Secret- und Laufzeitschutz zu betrachten.
Fazit
Kubernetes NetworkPolicy ist dann wirksam und wartbar, wenn dein CNI sie durchsetzt und jede Anwendungskante über stabile Labels beschrieben ist. Beginne mit einem Namespace, isoliere Ingress und Egress bewusst und erlaube DNS zuerst. Prüfe anschließend Objekt, Verbindung und Fehlverhalten statt nur YAML zu lesen. Für weitergehende L7-Regeln oder zentrale globale Steuerung nutze die dokumentierten Erweiterungen deines CNI gezielt.
Quellen
- Kubernetes Documentation: Network Policies
- Cilium Documentation: Using Kubernetes Constructs In Policy
- Calico Documentation: Enable a default deny policy for Kubernetes pods
- Kubernetes: Use Network Policies
Häufige Fragen
Eine NetworkPolicy definiert auf Layer 3 und 4, welche Pods, Namespaces, IP-Bereiche und Ports mit ausgewählten Pods kommunizieren dürfen. Sie benötigt einen Netzwerk-Plugin, der die Regeln durchsetzt.
Eine Default-Deny-Egress-Policy blockiert DNS-Verkehr. Deshalb braucht der Namespace vor weiteren Freigaben eine gezielte Regel für seinen DNS-Service.
Nein. Die Standardressource NetworkPolicy funktioniert mit jedem CNI, der ihre Durchsetzung unterstützt. Cilium ergänzt sie nur um eigene, weitergehende Policy-Ressourcen.
Die erlaubten Verbindungen aller Policies, die auf einen Pod zutreffen, werden vereinigt. Die Reihenfolge der Policies ändert das Ergebnis nicht.
Die Kubernetes-Standard-API deckt TCP, UDP und optional SCTP auf Layer 3/4 ab. Für HTTP-Pfade oder TLS brauchst du laut Kubernetes zusätzliche L7-Technik wie Service Mesh oder Ingress-Controller.
Schreibe einen Kommentar